概述
摘要作业失败后,记忆会永久停留在「摘要排队中」占位符状态,但被标记为 ready。占位文本本身也能算出向量,而就绪判定只看「有没有向量」,不看向量是拿什么算的。
结果是语义检索静默降级:这些记忆参与检索,但它们的向量表达的是「摘要排队中」这五个字,跟任何真实查询都不相关。没有任何报错、没有任何界面提示。
我这台机器上 7,318 条记忆里有 6,472 条(88%) 处于这个状态,持续了 10 天才被发现——而且是我自己去翻数据库才发现的,不是 memmy 告诉我的。
环境:memmy 2.1.2,macOS 12.7.6 (Intel)。
根因
1. 就绪判定只看向量是否存在
service/import/import-job-processor.js 的 restartFailedProcessing():
if (d.memories.hasVector(memory.id, "vec_summary")) {
    d.processing.update(memory.id, {
        state: "ready",
        stage: null,
        errorCode: null,
        errorMessage: null,
        failedAt: null,
        ...
    }, ["failed"]);
    continue;
}
而 storage/repositories.js 的 hasVector():
hasVector(memoryId, vectorField = "vec_summary") {
    const row = this.db.prepare(`SELECT 1 AS ok
       FROM memory_vector_entries
       WHERE memory_id = ? AND vector_field = ?
       LIMIT 1`).get(memoryId, vectorField);
    return Boolean(row);
}
它只问「有没有这一行」。占位符摘要同样会产生 vec_summary 行,所以这个分支会把 failed 记忆清成 ready,并抹掉 errorCode / errorMessage / failedAt——故障证据一并消失。
服务每次启动都会跑一遍 restartFailedProcessing(),所以失败痕迹会被反复清理。
2. 配置类失败被写死成永不重试
失败若被判定为配置问题(例如模型名失效),retry_action 会写成 'none'。之后 POST /api/v1/memory/:id/processing/retry 第一道闸就拒绝:
if (current.retryAction === "none" || !current.stage)
throw d.createError("conflict", current.errorMessage ?? "memory processing cannot be retried");问题在于它回显数据库里存的旧错误字符串,不重新探测当前配置。我把模型配置修好之后再调这个接口,拿到的仍然是:
{"error":{"code":"conflict","message":"unknown provider for model claude-sonnet-4"}}而 claude-sonnet-4 早已不在我的配置里。这些记忆没有任何官方途径能救回来。
3. 换嵌入模型会制造同类的静默失效
storage/sqlite-vec-store.js 的 search():
const compatible = candidates.filter((candidate) => candidate.embeddingDim === query.length);
if (compatible.length === 0)
    return [];
维度不匹配直接返回空。我把嵌入模型从 384 维换到 1024 维之后,6,659 条旧向量对检索完全不可见,同样不报错、界面上也看不出来。用户合理地以为「换个更好的模型」,实际是把大部分记忆从检索里摘了出去。
4. 推理模型下摘要预算不足(新失败的来源)
config/index.js:
export const MEMORY_SUMMARY_MAX_TOKENS = 512;
摘要模型如果是推理模型,reasoning 会吃光这 512 的输出配额,message.content 为空而 reasoning_content 有值,model/llm.js 抛 Reasoning exhausted the summary output token budget。
这不是历史遗留——我今天仍在产生新的这类失败。而它们最终会被第 1 条的逻辑洗成 ready。
复现
- 把摘要模型配成一个不可用的 provider/model
- 写入若干条记忆,等异步摘要作业失败
- 把摘要模型改回可用配置,重启服务
- 查
memory_processing_state:这些记忆是 ready
- 查
memories.info_json 的 summary 字段:仍然是 摘要排队中
- 用这些记忆的内容做语义检索:召回不到
-- 有多少「已就绪」的记忆其实还是占位符
SELECT COUNT(*) FROM memory_vector_entries e
JOIN memories m ON m.id = e.memory_id
WHERE e.vector_field = 'vec_summary'
  AND json_extract(m.info_json, '$.summary') LIKE '%排队中%';
期望行为
-
就绪判定要看摘要内容,不能只看向量是否存在。 占位符摘要不应算 ready——哪怕给个 ready_degraded 也好,至少别把它跟正常记忆混为一谈。
-
retry_action 的判定要重新探测,不能回显旧字符串。 配置已经改了,上一次的错误信息不再代表当前状态。
-
这些情况要让用户看得见。 现在 Viewer 里完全没有「你的记忆库有 88% 是空的」这个信息。哪怕只是在设置页加一行统计也够了。
-
换嵌入模型时提示旧向量会失效,并提供重嵌入口。
-
MEMORY_SUMMARY_MAX_TOKENS 对推理模型要放宽,或者至少在检测到 reasoning_content 非空、content 为空时给出可操作的提示。
我这边的临时方案
在等官方修复期间,我写了个本地工具,已开源:
https://github.com/eric1hua/memmy-backfill
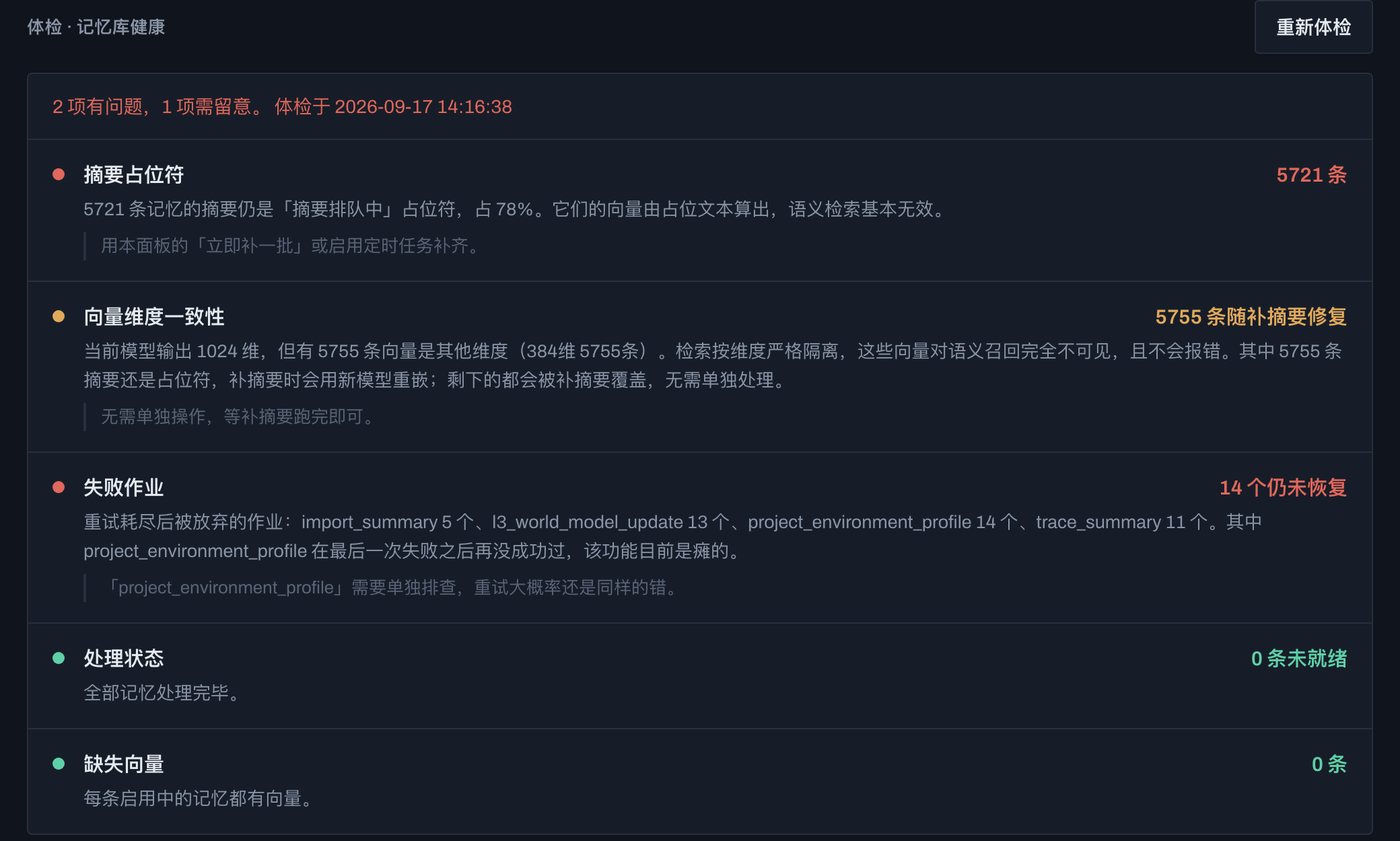
它做的事:
- 体检——扫出占位符摘要、维度失配的向量、dead-letter 作业、卡住的处理状态。其中「失败作业」会比对同类型作业最后一次成功与最后一次失败的时间,区分「真瘫了」和「历史噪音」
- 补全——按
memoryHasImportPipeline() 的规则正确选择 import_summary / trace_summary 重新入队(排错类型会被直接拒绝,这点花了我一些时间才搞清楚)
- 重嵌——把旧维度向量重嵌到当前模型的维度
- 解卡——放开
retry_action='none' 之后走官方的 processing/retry 接口
补全走 launchd,只在键鼠空闲 ≥5 分钟且 CPU 空闲 ≥50% 时运行,用户一回来立刻让路。
零第三方依赖,只用 Python 标准库,面板只绑 127.0.0.1。
这些逻辑如果对官方实现有参考价值,欢迎直接取用(MIT)。不过我更希望的是这个工具没有存在的必要——普通用户不会去翻 SQLite,他们只会觉得「memmy 的记忆好像不太准」,然后不知道为什么。
概述
摘要作业失败后,记忆会永久停留在「摘要排队中」占位符状态,但被标记为
ready。占位文本本身也能算出向量,而就绪判定只看「有没有向量」,不看向量是拿什么算的。结果是语义检索静默降级:这些记忆参与检索,但它们的向量表达的是「摘要排队中」这五个字,跟任何真实查询都不相关。没有任何报错、没有任何界面提示。
我这台机器上 7,318 条记忆里有 6,472 条(88%) 处于这个状态,持续了 10 天才被发现——而且是我自己去翻数据库才发现的,不是 memmy 告诉我的。
环境:memmy 2.1.2,macOS 12.7.6 (Intel)。
根因
1. 就绪判定只看向量是否存在
service/import/import-job-processor.js的restartFailedProcessing():而
storage/repositories.js的hasVector():它只问「有没有这一行」。占位符摘要同样会产生
vec_summary行,所以这个分支会把failed记忆清成ready,并抹掉errorCode/errorMessage/failedAt——故障证据一并消失。服务每次启动都会跑一遍
restartFailedProcessing(),所以失败痕迹会被反复清理。2. 配置类失败被写死成永不重试
失败若被判定为配置问题(例如模型名失效),
retry_action会写成'none'。之后POST /api/v1/memory/:id/processing/retry第一道闸就拒绝:问题在于它回显数据库里存的旧错误字符串,不重新探测当前配置。我把模型配置修好之后再调这个接口,拿到的仍然是:
{"error":{"code":"conflict","message":"unknown provider for model claude-sonnet-4"}}而
claude-sonnet-4早已不在我的配置里。这些记忆没有任何官方途径能救回来。3. 换嵌入模型会制造同类的静默失效
storage/sqlite-vec-store.js的search():维度不匹配直接返回空。我把嵌入模型从 384 维换到 1024 维之后,6,659 条旧向量对检索完全不可见,同样不报错、界面上也看不出来。用户合理地以为「换个更好的模型」,实际是把大部分记忆从检索里摘了出去。
4. 推理模型下摘要预算不足(新失败的来源)
config/index.js:摘要模型如果是推理模型,reasoning 会吃光这 512 的输出配额,
message.content为空而reasoning_content有值,model/llm.js抛Reasoning exhausted the summary output token budget。这不是历史遗留——我今天仍在产生新的这类失败。而它们最终会被第 1 条的逻辑洗成
ready。复现
memory_processing_state:这些记忆是readymemories.info_json的summary字段:仍然是摘要排队中期望行为
就绪判定要看摘要内容,不能只看向量是否存在。 占位符摘要不应算
ready——哪怕给个ready_degraded也好,至少别把它跟正常记忆混为一谈。retry_action的判定要重新探测,不能回显旧字符串。 配置已经改了,上一次的错误信息不再代表当前状态。这些情况要让用户看得见。 现在 Viewer 里完全没有「你的记忆库有 88% 是空的」这个信息。哪怕只是在设置页加一行统计也够了。
换嵌入模型时提示旧向量会失效,并提供重嵌入口。
MEMORY_SUMMARY_MAX_TOKENS对推理模型要放宽,或者至少在检测到reasoning_content非空、content为空时给出可操作的提示。我这边的临时方案
在等官方修复期间,我写了个本地工具,已开源:
https://github.com/eric1hua/memmy-backfill
它做的事:
memoryHasImportPipeline()的规则正确选择import_summary/trace_summary重新入队(排错类型会被直接拒绝,这点花了我一些时间才搞清楚)retry_action='none'之后走官方的processing/retry接口补全走
launchd,只在键鼠空闲 ≥5 分钟且 CPU 空闲 ≥50% 时运行,用户一回来立刻让路。零第三方依赖,只用 Python 标准库,面板只绑
127.0.0.1。这些逻辑如果对官方实现有参考价值,欢迎直接取用(MIT)。不过我更希望的是这个工具没有存在的必要——普通用户不会去翻 SQLite,他们只会觉得「memmy 的记忆好像不太准」,然后不知道为什么。